


具身智能需要什么数据?一文看懂本体、仿真、第一人称与 UMI 数据
一个机器人第一次走进厨房,让它把水倒进杯子。它没见过这只杯子,也没摸过这把水壶,却要一次做对。
人的孩子看两遍就会了。机器人要靠数据。问题是,拍一段视频给机器人看,它学不会。倒水的动作背后有手腕的转角、夹爪的力度、水壶的重心、桌面的摩擦,这些东西藏在画面之外。
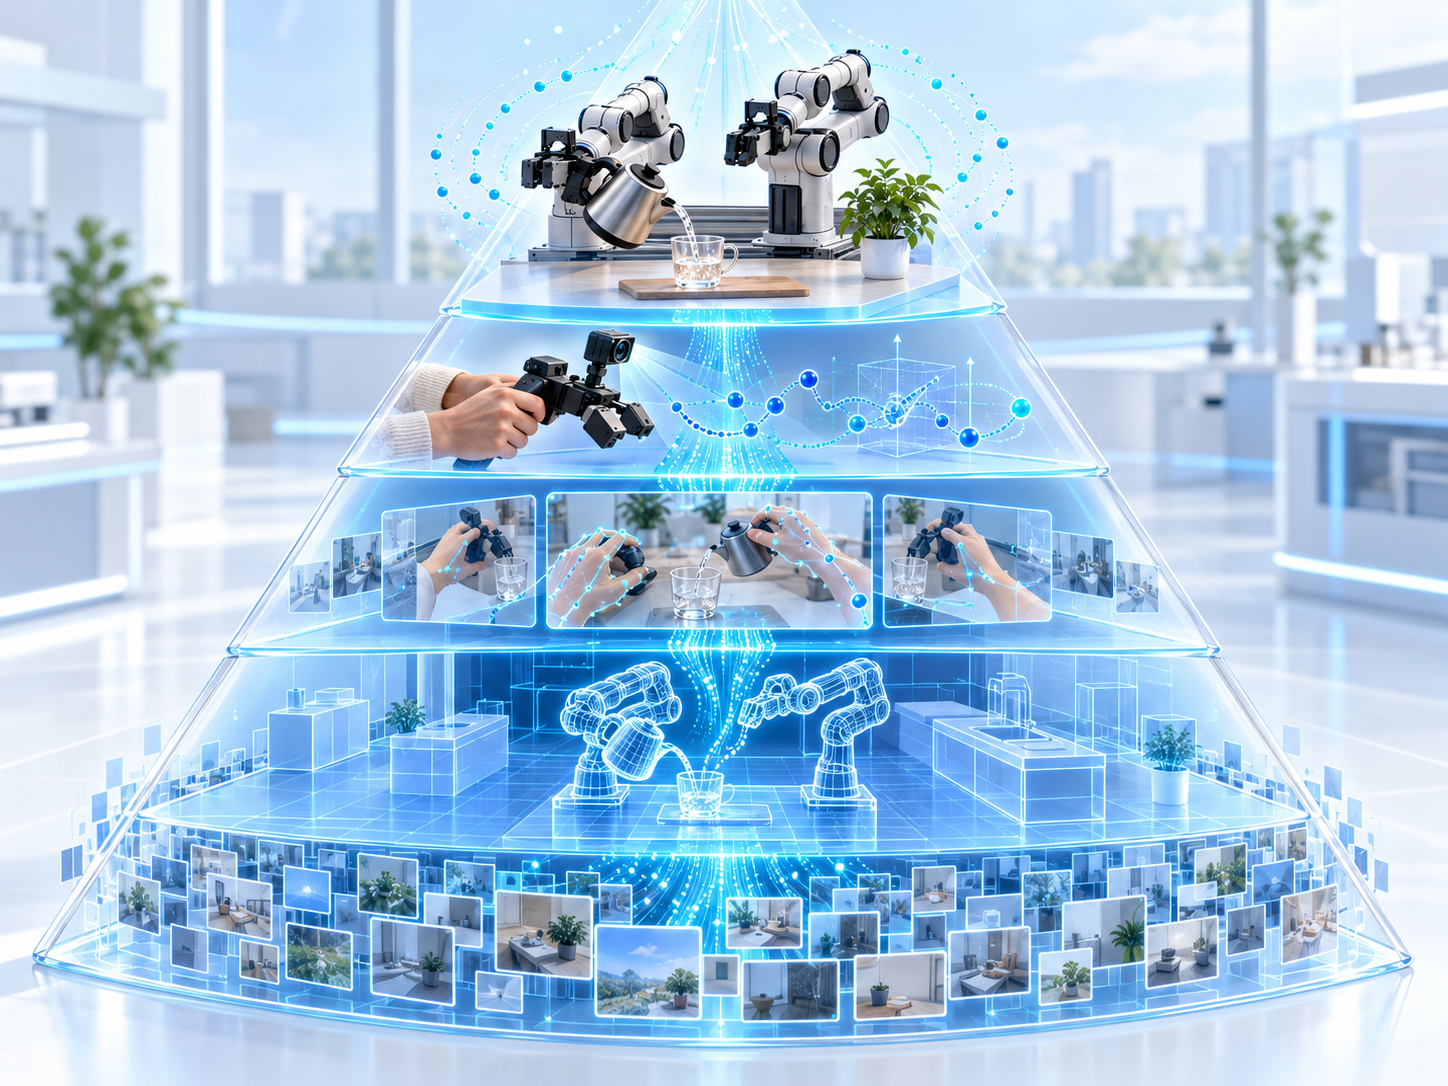
行业里把这些“原料”分成五层,像一座金字塔:越往上越接近真机、越贵、量越少;越往下越通用、越便宜、量越大。下面从塔尖往下,一层一层说清楚。
第一层,真机数据:最贵,也最直接
操作员戴上 VR 头显,遥控机器人把盒子从桌面搬到货架。相机画面、关节角度、夹爪开合、力传感器读数、这一条成没成功,全部录下来。
这类数据是唯一可以直接喂给同款机器人执行的动作数据。物理细节齐全,机器人摔倒、抓空、卡住的瞬间也在里面。
代价是贵。一台机械臂加几套相机,几万到几十万;采一条要人盯着;换一个场景要重新摆台子。所以真机数据的增长很慢。
规模最大的几套公开数据是这样攒出来的:Open X-Embodiment 汇集了 22 种机器人、60 个数据集、100 万条以上轨迹;DROID 用了 18 套设备、50 位采集者、跨三大洲采了 12 个月,得到 7.6 万条;智元的 AgiBot World 放出了约 100 万条,总量 850TB。
第二层,UMI 手持数据:拿人手去“演”
人手里握一个小夹爪,上面装着鱼眼相机和惯性传感器,在桌上把活儿做一遍。机器人在旁边看着,记录夹爪尖在空间里的位置和朝向。
硬件成本万元级别,采集成本约为真机的十分之一。一个人一下午能采几百条,室内室外都能拍,不用搬机器人。采回来的末端轨迹,可以通过逆运动学换算成各种机械臂的关节角度,跨硬件迁移的门槛低。FastUMI 已经把硬件图纸和采集代码开源,社区里百万条规模的数据集已经出现。
短板在“没有身体”。机器人关节的延迟、惯量、力量反馈,这些信号它一条都记不到。大负载、高速度、需要力控的活儿,用这批数据训练会明显失真。相机被手挡住时,位姿跟踪也会掉精度。灵巧手的任务基本做不了。
第三层,人类第一视角视频:用日常补课
头上戴个相机,或者脖子上挂个手机支架,记录自己做饭、拧瓶盖、系鞋带的整个过程。
这层数据的价值在于人手。人有二十多个自由度,捏、拧、捻、按这些精细动作,机器人数据里几乎没有,人类视频里遍地都是。Ego4D 采了 3670 小时,覆盖 74 个地点;苹果的 EgoDex 有 829 小时,每只手 25 个关节的三维位置都做了追踪,涉及 194 个任务;蚂蚁的 AoE 系统用一部手机加一个 20 美元的颈挂支架就能全天采集。
瓶颈在“翻译”。人手的结构和机械手差得远,得先把视频里的手重建出来,再把动作改写成机器人能执行的指令。这一步的误差会一路带进训练,所以数据量大,可用比例未必高。
第四层,仿真数据:在虚拟世界里批量造
在物理引擎里搭一个虚拟厨房,让虚拟机器人反复练。一秒钟能跑几百次,不用休息,也不会摔坏。
NVIDIA 的 MimicGen 用少量真人演示当种子,在仿真里换物体、换位置、换光照,11 小时生成 78 万条轨迹,相当于一个操作员连续干 6500 小时。危险工况、失败案例、极端场景都可以随意造,标注还能自动生成。
短板是“像不像”。摩擦系数、软体形变、流体流动,仿真里和真机始终有差距,业内叫 sim-to-real gap。虚拟场景也受限于已经建好的三维资产库,真实世界的长尾情况覆盖不全。所以现在的主流用法是:仿真先打底,真机再微调。
第五层,通用图文视频:教会模型常识
全网的照片、短视频、图文问答。这层数据里没有动作,也没有接触和力,但它能让模型知道水往低处流、杯子掉地上会碎、把手在杯子侧面。
它是所有模型的底座。没有这层,模型认不出物体,也听不懂“把桌上的杯子递给我”这种指令。有了这层,它也只能做到底座,控制策略还得靠上面四层。
数据越多就越好吗
清华大学和上海期智团队做过一组实验:用 UMI 采集超过 4 万条演示,在真实机器人上评测了 1.5 万次。
结论是,机器人的泛化能力跟“见过多少个环境、多少个物体”大致成幂律关系。同一个场景里重复采到五十条左右,再加就没什么收益了。演示的绝对数量远没有场景的丰富度重要。
他们在四个任务上验证过:四个人用一个下午采的数据,换到全新的环境、没见过的物体,成功率能到 90% 左右,倒水 85%、鼠标摆放 92.5%、叠毛巾 87.5%、拔充电器 90%。
数据配比同样关键。π0.5 用了六类异构数据一起训练,拆掉任何一类都会掉点,其中跨本体数据和多环境数据影响最大。有意思的是网络数据:去掉它,在训练分布内的任务上几乎看不出变化;换到没见过的物体上,语言理解和泛化能力明显下降。
回到金字塔
把五层重新看一遍,分工其实很清楚。
真机数据在塔尖,负责最后那一步落地。它回答的是“这个动作在真机上能不能做对”,数量少,但每一条都值钱。
UMI 和人类第一视角在中间偏上,负责把动作见过的世面撑开。同样的预算下,它们能覆盖的物体、环境、场景数量,远超过真机采集。
仿真在中间偏下,负责把危险、极端、稀有工况补上,顺便把标注成本压到接近零。
通用图文视频在塔底,负责让模型认识世界。它教会模型杯子是什么、水往哪流,至于怎么抓、怎么倒,得靠上面四层。
没有哪一层能单独撑起一个机器人。缺了塔尖,模型在真机上掉点;缺了中间,换个场景就失灵;缺了塔底,连指令都听不懂。真正拉开差距的,在于怎么把它们按合适的比例配在一起,用有限的预算覆盖尽量多的场景。
