


具身智能玩汉诺塔?!
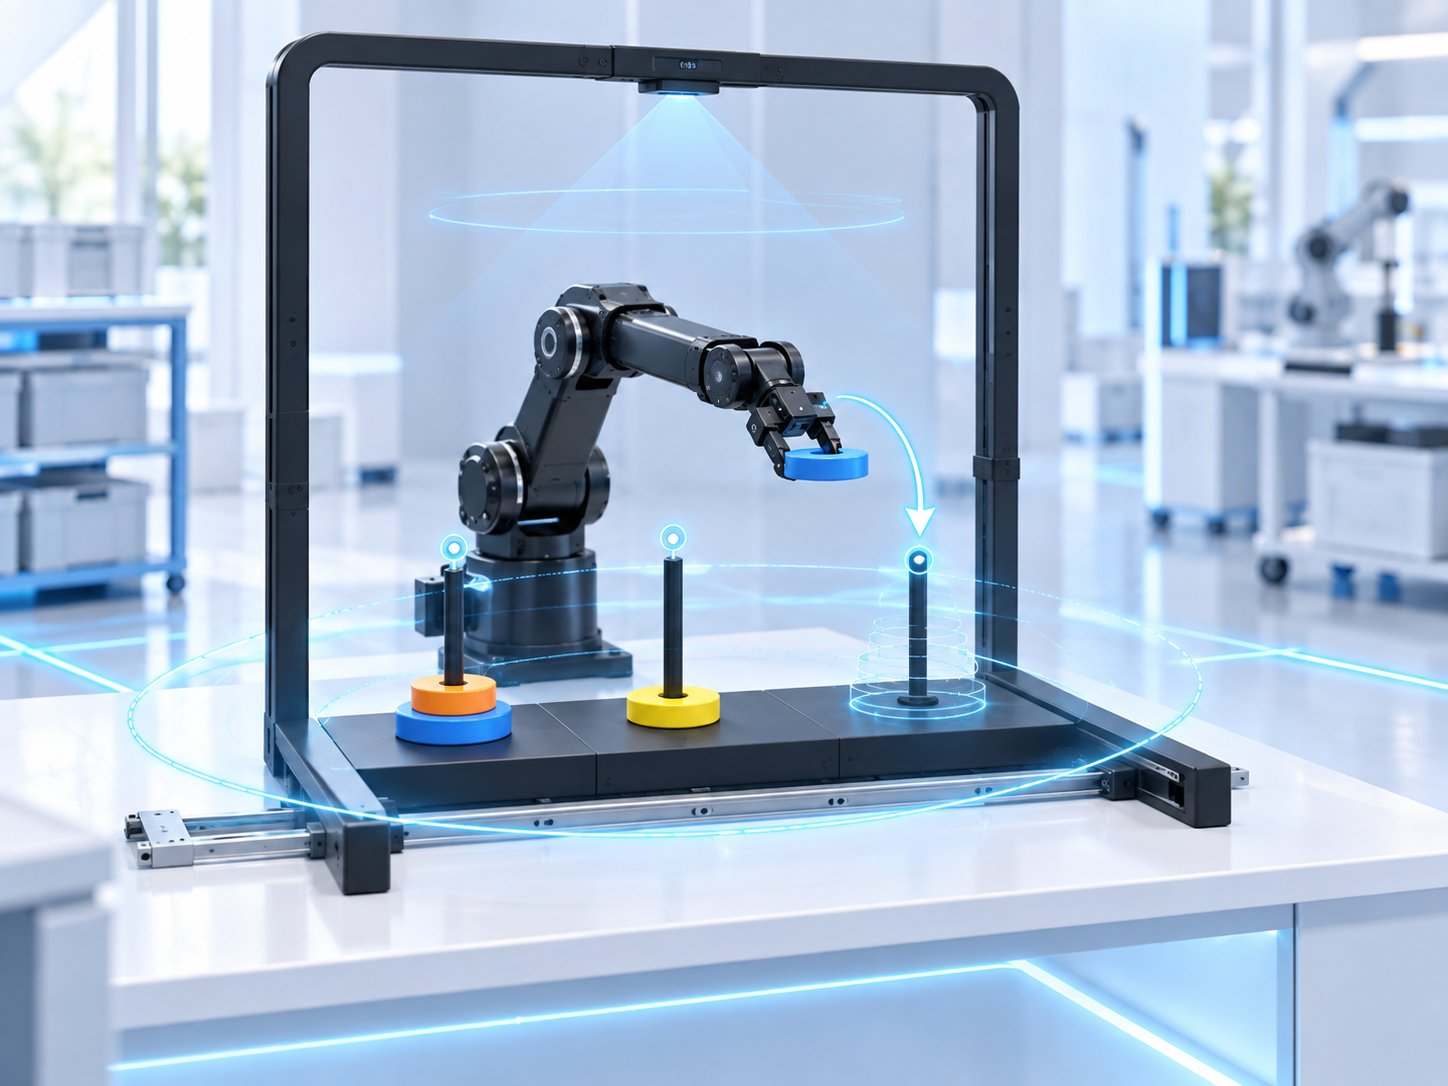
汉诺塔的规则很简单:把大小不同的圆盘从一根柱子移到另一根柱子,每次只能移动一个,大盘不能压在小盘上。让机械臂自主完成这项任务,需要连续感知圆盘位置、判断当前状态、规划下一步并准确执行。
在 WRC 2026 现场,具身汉诺塔使用单一模型完成七步连续操作,累计运行近 40 个小时。观众移动底座、改变圆盘状态或混合不同外观的组件后,机械臂仍能继续完成任务。
这套演示集中体现了模型的长程记忆、逻辑推理、高精度以及恢复能力。
长记忆:一个模型完成连续七步
三层汉诺塔至少需要七步才能完成。每移动一个圆盘,都会产生新的局面,并影响下一步操作。
模型需要持续掌握任务目标、圆盘分布和执行进度。一次操作结束后,新的状态会成为下一次判断的依据。
这里的记忆体现为对任务状态的连续理解:当前完成了哪些操作,圆盘分别在哪里,下一步应该移动哪一个。
高泛化:位置和形状改变也能快速调整
大多数机器人演示按固定轨迹跑,每个动作提前写死。位置变了、顺序变了,就得重新配置,再从第一步跑一遍。
这套设备可以被打断。现场你可以随时上手干预:
-
移动底座,改变圆盘和柱子的整体位置。
-
把已抓起的圆盘放回任意一柱,将任务切换到不同的中间状态。
-
混合不同外观的汉诺塔组件,改变圆盘的颜色和样式。
松手之后,它能重新认出当前局面,判断哪些步骤已经完成、下一步该动哪个盘,然后接着做。

支撑这一切的,是模型本身
支撑上面这些的,是仙工自研 VLA 模型。
VLA 即视觉—语言—动作模型,它读眼前的真实场景,输出一段连续决策。轨迹回放把动作原样播出,中途被打断就断了;VLA 每一刻根据眼前局面重新判断,所以能从任意一步接上。
判断的覆盖范围,直接体现模型的能力。三个盘子各自只能待在三根柱子之一,组合起来一共 27 种状态。这 27 种它全都认得:观众把塔拨成哪一种,它都能读出当前局面,判断下一步该动哪个盘。
做到这一点,只用了 60 条数据。现场很多人听到这个数字都不信。 60 条数据也只做了一件事——让机械臂认识这套设备的具体形态和操作流程。而观众拨出的局面,绝大多数不在那 60 条里。滑轨被推走、道具被混搭、塔被拨到任意一步,它依然接得住。
因为决定能力上限的是模型,不是数据。60 条只是起点,不是它的边界。

从三层汉诺塔走向更长流程
长程、高记忆、强推理——汉诺塔考的正是模型的记忆、泛化和恢复能力。只要模型足够强,它就能玩得足够好。
三层的答案你已经看到了。五层呢?
敬请期待。
